Un singur flag: cum rulezi modele AI masive pe un laptop cu 8GB
Cum se optimizează fluxul de memorie? Comunitatea locală de AI a descoperit recent că plafonul de 8GB memorie video nu este o barieră absolută pentru rularea modelelor de limbaj mari. Entuziaștii…
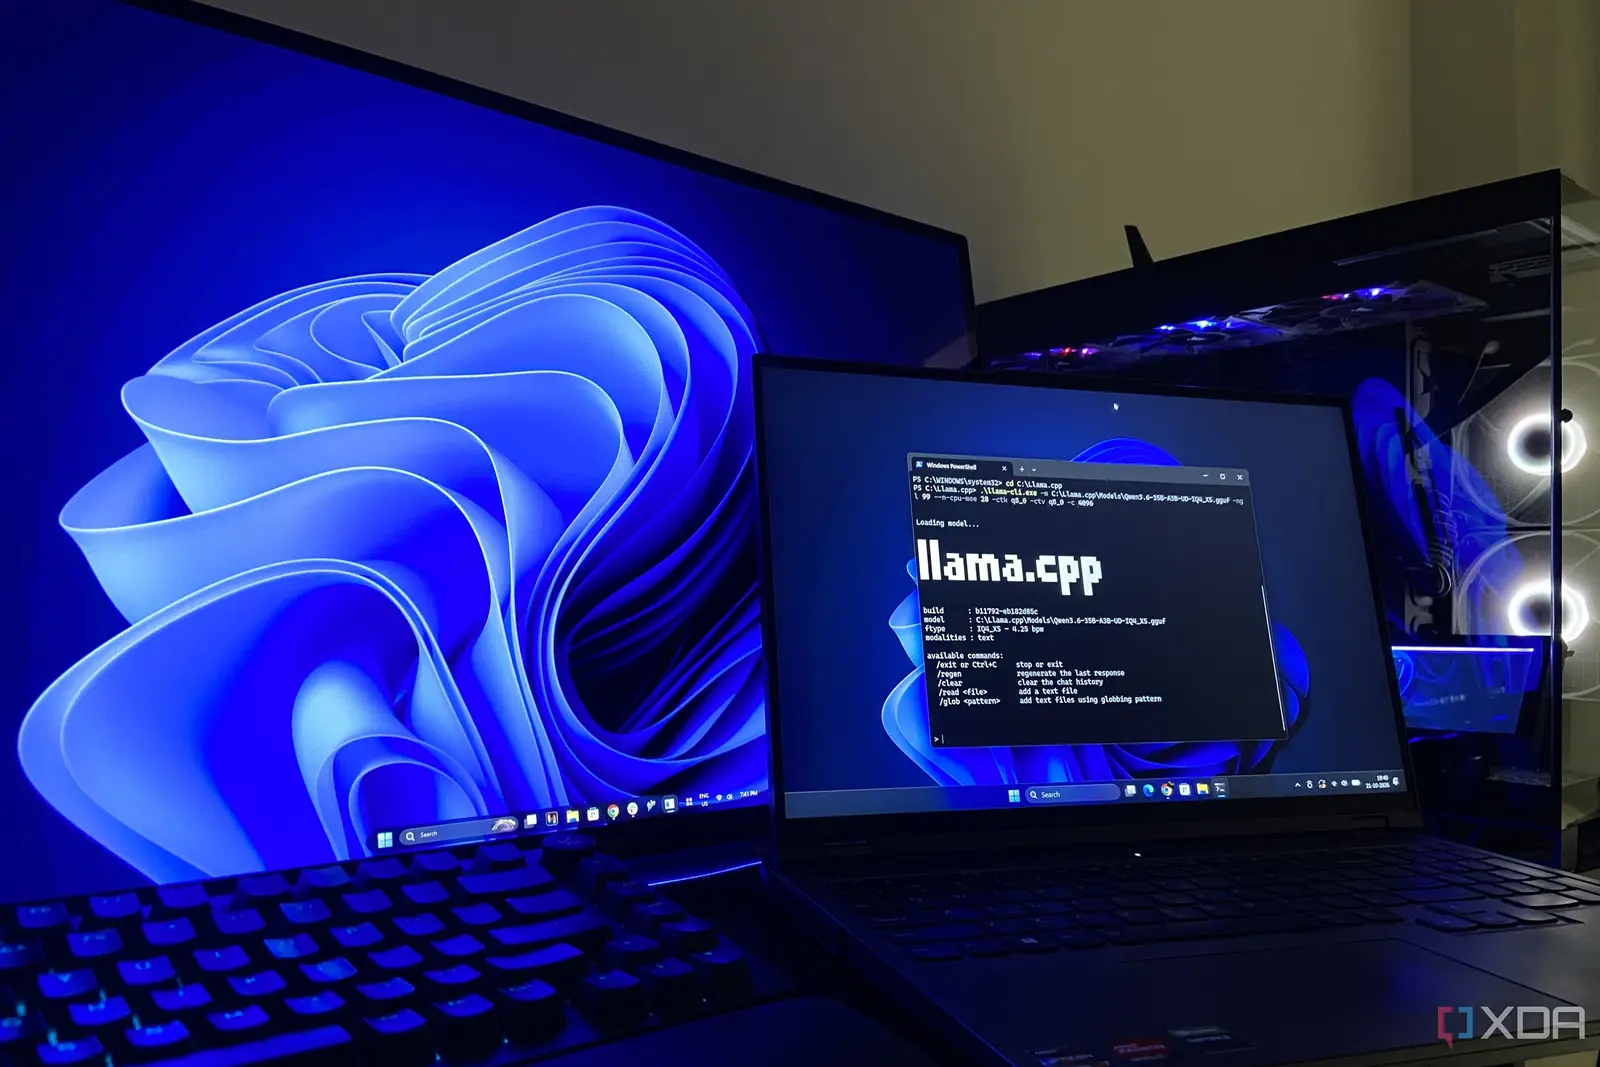
Cum se optimizează fluxul de memorie?
Comunitatea locală de AI a descoperit recent că plafonul de 8GB memorie video nu este o barieră absolută pentru rularea modelelor de limbaj mari.
Entuziaștii au identificat faptul că ajustarea unui singur flag în motorul de inferență llama. cpp permite funcționarea eficientă a modelelor cu 35 de miliarde de parametri pe hardware modest.
Această evoluție sugerează că configurația software contează adesea mai mult decât specificațiile brute ale hardware-ului. Schimbarea arată cum utilizatorii pot debloca câștiguri semnificative de performanță fără a-și înlocui placa grafică.
Gâtul de sticlă principal pentru utilizatorii de AI local a fost mereu capacitatea RAM-ului video.
Majoritatea laptopurilor moderne vin echipate cu 8GB memorie dedicată, ceea ce îi limita tradițional pe utilizatori la modele mai mici și mai puțin capabile. Totuși, noile insight-uri indică faptul că gestionarea ineficientă a memoriei era cauza reală. Prin optimizarea modului în care datele se deplasează între RAM-ul de sistem și VRAM-ul GPU, dezvoltatorii pot menține active modele mai mari.
Această abordare previne blocările și întârzierile care au afectat anterior utilizatorii care încercau să ruleze sarcini grele pe dispozitive de consum.
Modificarea specifică implică ajustarea modului în care biblioteca llama. cpp gestionează descărcarea straturilor. În loc de a forța toate ponderile modelului în memoria GPU limitată, flag-ul ajustat permite o distribuție mai inteligentă a sarcinilor.
Hardware-ul mai contează?
Sistemul păstră cele mai critice straturi pe GPU-ul rapid, parcase restul în memoria de sistem mult mai mare. Această abordare hibridă asigură că procesorul accesează RAM-ul mai lent doar când este absolut necesar. În consecință, modelul generează tokeni la viteze care rivalizează cu rata de citire a omului.
Utilizatorii raportează că această simplă ajustare transformă o experiență lentă într-una fluidă. Rezultatul este o reducere dramatică a metricilor de timp până la primul token pentru prompturi complexe.
Metoda se bazează pe faptul că CPU-urile și busurile de memorie moderne sunt semnificativ mai rapide decât în trecut. Memoria DDR5 de viteză ridicată poate alimenta GPU-ul suficient de repede pentru a menține o ieșire constantă. Cheia este minimizarea frecvenței acestor transferuri. Când flag-ul este setat corect, motorul de inferență bachează operațiile eficient. Acest lucru reduce overhead-ul asociat mutării datelor în ambele direcții. Pentru dezvoltatorii care construiesc aplicații locale, aceasta înseamnă că pot oferi funcții AI de calitate superioară fără a cere hardware scump clienților.
Bariera de intrare pentru AI local de nivel înalt scade considerabil.
Mulți utilizatori presupun că upgrade-ul la un GPU de 16GB sau 24GB este singura cale spre performanță mai bună. Deși mai mult VRAM ajută cu siguranță, nu este strict necesar pentru fiecare caz de utilizare.
Descoperirile recente sugerează că o placă de 8GB bine ajustată poate depăși o placă de 16GB configurată prost. Acest rezultat contraintuitiv provine din eficiența procesului de schimbare a memoriei. Dacă rata de swap este scăzută, penalizarea de viteză este neglijabilă.
Un singur flag deblochează modele de 35B pe doar 8GB de VRAM!
Utilizatorii care au abandonat modelele mari din cauza constrângerilor de hardware ar trebui să își revizueze setările. Testarea diferitelor flag-uri și configurații poate produce rezultate surprinzătoare. Focusul trebuie să se deplaseze de la cumpărarea mai multor memorii la gestionarea eficientă a memoriei existente.
Această tehnică necesită un CPU specific? Nu, optimizarea funcționează cu orice CPU modern care suportă memorie de viteză ridicată.
Beneficiul provine din transferul eficient de date, nu din puterea brută de procesare.
Funcționează și pentru modelele de generare de imagini? Deși principiul se aplică în general, flag-ul specific discutat aici țintește modelele de limbaj bazate pe text.
Generatoarele de imagini au adesea cerințe și gâturi de sticlă diferite pentru memorie.
Creșterea de viteză este permanentă? Da, odată ce configurația este salvată, câștigul de performanță persistă.
Nu este nevoie să reapli setarea de fiecare dată când pornești o sesiune nouă.
Sursă XDA Developers
Opinii
Nicio opinie încă. Scrie prima.
Mai multe din Hardware
ASUS ProArt P16: Putere extremă pentru pasionații de AI?
Microsoft a dezvăluit prețul pe oră pentru Xbox Cloud Gaming
Plasele Nvidia RTX 5090 furate din aeroport reapar pe piața secundară
Secrete ascunse în jocurile N64: ce dezvăluie upscaling-ul 4K
Raspberry Pi 5 rulează AI local: suficient pentru jumătate din proiectele tipice